大语言模型正从简单的「对话框」演变为具备自主规划、工具调用和多机协同能力的 AI Agent。随之而来的,是整个开发者技术栈的剧变。
如果你正准备进入 AI Agent 开发领域,或者正照着市面上的传统路线图学习,会发现一个扎心的事实:两年前那套「黄金法则」(比如简单的 API 包装),面对如今复杂的企业级应用,已经捉襟见肘。这篇路线图结合最新的工业界落地实践——MCP 协议、GraphRAG、结构化输出——对传统学习路线做了一次全面升级与重构,希望能帮你少走弯路。
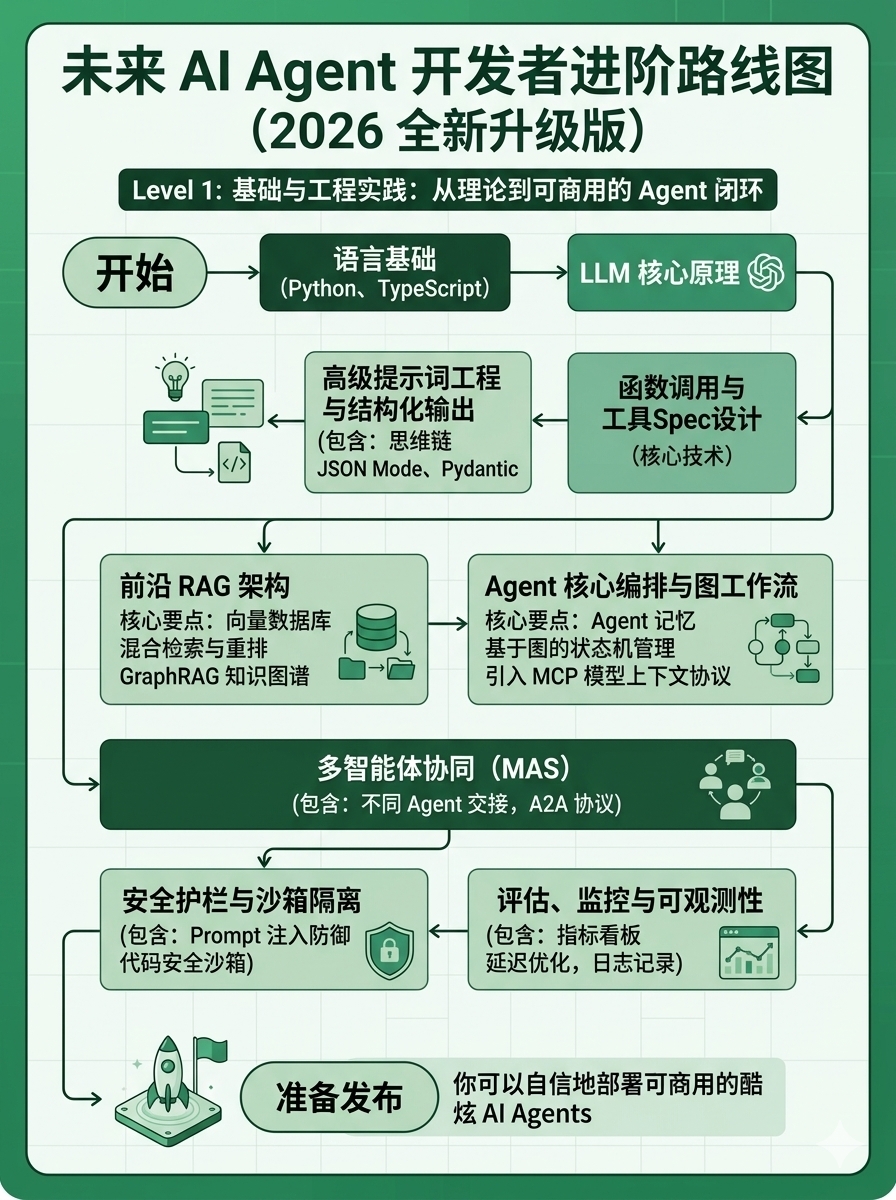
一、核心概念升级:从「API 包装」到「结构化输出与函数调用」
传统路线的第一个盲区,是把 API Wrappers(API 包装) 当核心,重点全放在怎么调 OpenAI、Anthropic 的接口上。
但在今天的 Agent 开发里,简单的 API 调用只是基本功。大模型作为 Agent 的「大脑」,真正的任务是把人类的自然语言翻译成计算机可以执行的指令。所以你必须攻克两件事:
- 100% 稳定的结构化响应:深入掌握模型的 JSON Mode 和 Pydantic,保证输出格式绝对可解析——这是 Agent 能稳定驱动下游系统的地基。
- 工具描述规范(Tool Spec):理解大模型如何根据你写的函数描述(Docstring),自主、精准地判断「何时调用工具」「如何组合参数」。
二、补全核心缺失:掌握「状态管理」与「基于图的工作流」
传统路线图只会提「编排(Orchestration)」,给初学者的错觉是:Agent 执行是一条线性的、顺理成章的流程。
现实完全不是这样。复杂的 Agent 往往要在多个状态之间反复横跳、循环流转,甚至需要人类干预。状态管理(State Management) 和 持久化(Persistence),才是现代复杂 Agent 系统的命脉。建议重点学:
- 基于图的工作流(Graph-based Workflows):学习 LangGraph、AutoGen 代表的「图结构」设计思想,掌握在复杂、非线性任务中管理 Agent 全局状态的方法。
- 时间旅行与人机协同(Time-travel & Human-in-the-loop):让 Agent 在高风险决策(转账、删数据)时中断并等待人类审批;出错后能回滚到任意历史状态重新执行。
三、深化 RAG 模块:拥抱「混合检索」与「GraphRAG」
很多教程对 RAG 的拆解还停留在老三样:「文本分块 ➡️ 向量化 ➡️ 向量检索」。但在实际场景里,纯向量检索缺乏全局关联,经常让 Agent「只见树木,不见森林」。
Agent 的知识库要实现更高级的推理,必须引入 GraphRAG(知识图谱增强检索) 和 混合检索:
- GraphRAG 架构:从文档中提取实体与关系、构建知识图谱,让 Agent 有能力回答高度概括性、全局性的复杂问题。
- 混合检索与重排(Hybrid Search & Reranking):把传统关键词检索(BM25)与密集向量检索结合,再用 Reranker 做二次过滤——这是目前工业界提升检索准确率的标准配置。
四、筑牢安全防线:构建「智能体护栏(Guardrails)」
绝大多数学习路线图都完全忽略了安全(Security)。但一个能写代码、读写文件、甚至调用第三方支付 API 的 Agent,一旦遭遇恶意攻击,后果是灾难性的。
在 Agent 投入生产之前,必须设计一套严密的 安全与护栏 系统:
- Prompt 注入与越狱防御:识别并拦截用户输入的恶意诱导提示词。
- 输入/输出隔离护栏:用 NeMo Guardrails、Llama Guard 等工具,在输入端和输出端各加一层安全边界,防止敏感信息泄露和违规输出。
- 沙箱执行环境(Sandbox Execution):Agent 生成并执行的代码(Python、Shell 脚本)必须跑在完全隔离的容器环境里。
五、降本增效:从「盲目微调」转向「本地端侧大模型部署」
过去的路线图一上来就推荐学「微调(Fine-tuning)」。但微调成本极高、数据准备繁琐,而且往往不是解决 Agent 推理能力不足的第一手段。
随着开源生态爆发,现阶段更务实、性价比更高、也更有商业价值的技能,是本地轻量级模型的部署与极致榨干:
- 本地运行与量化:熟练用 Ollama、Llama.cpp 在本地或私有服务器上部署 8B 到 70B 级别的开源大模型。
- 小模型的 Tool Call 调优:通过精简提示词,让 Qwen2.5-7B、Llama-3-8B 这类本地小模型,在特定垂类工具调用任务上达到媲美云端大模型的高成功率。
终极推荐:2026 重构版九步学习路径
为了让你顺畅吸收以上知识,建议按这个闭环顺序学习:
- 语言基础(Python / TypeScript)
- LLM 核心原理(理解上下文窗口与基础模型能力)
- 高级提示词工程与结构化输出(思维链 CoT ➡️ JSON Mode / Pydantic)
- 函数调用与工具 Spec 设计(掌握大模型调用外部世界的本质)
- 前沿 RAG 架构(向量数据库 ➡️ 混合检索 ➡️ GraphRAG)
- Agent 核心编排与图工作流(Agent 记忆 ➡️ 基于图的状态机管理 ➡️ 引入 MCP 模型上下文协议)
- 多智能体协同(MAS)(不同 Agent 的交接与 A2A 协议)
- 安全护栏与沙箱隔离(Prompt 防御与代码安全执行)
- 评估、监控与可观测性(指标看板、延迟优化与日志记录)
结语
AI Agent 开发的技术栈正在快速重构:结构化输出代替 API 包装、图工作流代替线性编排、GraphRAG 补全向量检索、安全护栏成为必修课、本地模型走向台前。这条路线图来自 2026 年的工业界落地实践,把它当成一份导航,而不是终点——技术会变,但「让模型可靠地执行真实任务」这件事,始终是核心。